Adicionar IA ao sistema sob medida ficou mais barato — mas isso, sozinho, não decide se vale a pena. Nas últimas semanas a OpenAI cortou pela metade o preço dos tokens de API dos modelos GPT-6 Sol e Luna, e chamou o corte de permanente, não de promoção passageira. Se você já tem um sistema sob medida rodando e vive se perguntando se chegou a hora de acrescentar uma funcionalidade de IA, essa notícia muda a conta de um jeito específico — e vale entender qual.
O que a OpenAI cortou, e por quanto
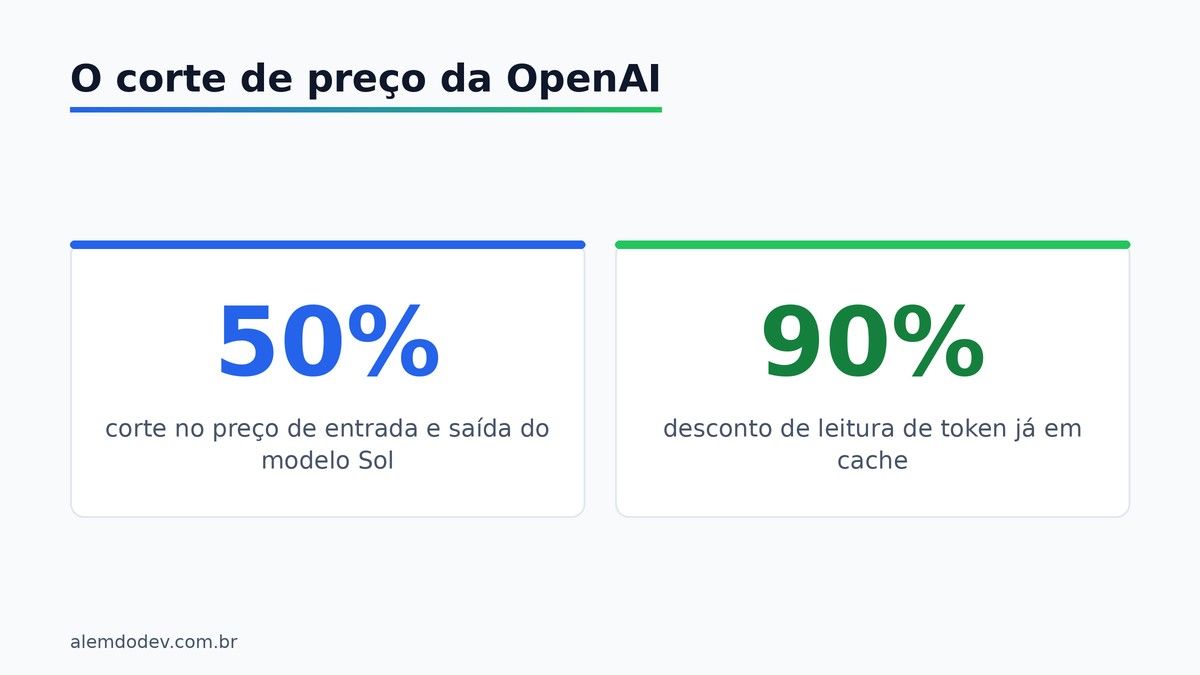
O modelo Sol, usado em tarefa mais pesada, caiu de US$ 4 e US$ 20 por milhão de tokens de entrada e saída para US$ 2 e US$ 10. O Luna, versão mais leve e usada em tarefa de volume alto, caiu de US$ 0,20 e US$ 1,20 para US$ 0,10 e US$ 0,50. A OpenAI ainda ampliou o desconto de leitura de token já em cache para 90%, o que baixa ainda mais o custo de uma conversa que reaproveita o mesmo contexto várias vezes.
A empresa atribuiu o corte a ganho de eficiência de inferência e cache — não a uma promoção de lançamento que volta ao preço cheio depois de um tempo. É esse detalhe que muda a conta de quem está decidindo se vale adicionar IA ao sistema que já tem: o custo que inviabilizava um recurso há seis meses pode já não inviabilizar mais, de forma permanente, não só numa janela promocional.
Por que essa notícia fala diferente para quem já tem sistema
Já mostramos aqui por que esperar o preço da IA cair não é motivo para adiar a contratação de um sistema sob medida — o preço de um sistema sempre foi cobrado pelo levantamento do processo e pelo desenho da tela, não pela execução do modelo por trás.
Este texto fala do lado oposto do mesmo problema. Você não está contratando nada: já tem o sistema rodando, sabe exatamente o que ele faz hoje, e quer saber se uma funcionalidade de IA que ficou de fora do escopo original — por custo, por prioridade, ou pelas duas coisas — já vale a pena pedir como aditivo. Para quem está nessa posição, o custo de rodar o modelo deixa de ser abstrato: é ele, direto, que decide se acrescentar IA ao sistema fecha a conta.
Onde a IA embutida realmente economiza
Três funcionalidades saem do papel com mais frequência quando o custo de token cai, porque são justamente as que consomem token toda hora — não uma vez por dia, mas a cada mensagem ou a cada busca:
- Busca em linguagem natural no cadastro: em vez de aprender qual filtro cruza com qual campo, o usuário digita a pergunta do jeito que perguntaria a um colega, e o sistema devolve o registro certo.
- Resumo automático de atendimento: o histórico de WhatsApp, e-mail e ligação de um cliente vira um resumo de trinta segundos, pronto antes de a reunião começar.
- Triagem de mensagem: separa o que precisa de resposta humana do que é rotina — confirmação de horário, dúvida repetida, agradecimento — antes de chegar à caixa de entrada de alguém.
As três têm em comum um padrão de uso que consome bastante token: leem um histórico grande, ou rodam a cada evento novo, o dia inteiro. É exatamente esse padrão de uso intenso que o corte de preço da OpenAI atinge com mais força — a funcionalidade que rodava pouco por causa do custo passa a caber no orçamento sem mudar o desenho.
Antes do corte, um escritório com centenas de conversas por mês esbarrava no custo de gerar um resumo para cada uma. Depois, o mesmo volume de resumo custa menos da metade — e é isso que muda a resposta de "vale a pena" para "não vale mais esperar".
Preço mais baixo não é sinal verde sozinho
Preço de token mais baixo muda a conta de uma funcionalidade específica. Não é sinal verde para adicionar IA em qualquer parte do sistema.
Já escrevemos aqui que IA não aumenta a produtividade sozinha — o mesmo vale para uma funcionalidade nova dentro do sistema que você já tem. Se o processo por trás da triagem de mensagem não está claro hoje — ninguém sabe dizer o que conta como urgente, ou a regra muda de pessoa para pessoa —, colocar um modelo de IA para fazer essa triagem não resolve. Só troca o lugar onde a confusão acontece, de uma pessoa despreparada para um prompt mal desenhado.
O corte de preço barateou a execução. Não resolveu a parte que sempre foi a mais difícil: decidir exatamente o que a funcionalidade deve fazer, e o que ela nunca deve decidir sozinha.
Quatro perguntas antes de pedir o aditivo
- A funcionalidade resolve uma dor que você já sente hoje, ou é uma aposta de que vai precisar dela?
- Alguém no time consegue revisar o que a IA gera, pelo menos no começo, até a confiança se firmar?
- O processo que a IA vai automatizar já é claro sem ela — ou a confusão está no processo, não na falta de IA?
- O ganho de tempo mensal paga o custo de manutenção contínuo, não só o custo de implementar uma vez?
Se a resposta às quatro for sim, o momento de pedir o aditivo provavelmente já chegou. Se alguma travar, vale resolver essa parte antes — de preferência sem IA nenhuma envolvida — e voltar à pergunta depois.
Como isso entra no seu sistema hoje, em números reais
A forma de contratar já é conhecida: manutenção recorrente e aditivo de escopo, o mesmo modelo usado para qualquer evolução do sistema depois da entrega inicial — não é um projeto novo do zero. Hoje a manutenção de sistema tem três faixas: o plano Essencial, com até 4 horas técnicas por mês; o Plus, com até 10 horas e prioridade de atendimento; e o Dedicado, com escopo desenhado caso a caso para demanda maior.
Uma funcionalidade pontual — a triagem de mensagem, por exemplo — costuma caber dentro das horas de um plano Plus já contratado, sem virar contrato novo. Uma funcionalidade maior, que exige levantamento de tela e integração própria, entra como aditivo ou ordem de serviço à parte, com preço conforme o tamanho do escopo, o mesmo desenho usado em qualquer evolução robusta de sistema já em produção.
O que muda com o corte de preço da OpenAI é o outro lado da conta: o custo recorrente de rodar o modelo, que soma ao custo de desenvolvimento único, ficou menor de forma permanente. Isso desloca para baixo o ponto a partir do qual acrescentar IA ao sistema sob medida se paga sozinho, mês a mês.
Um exemplo por segmento
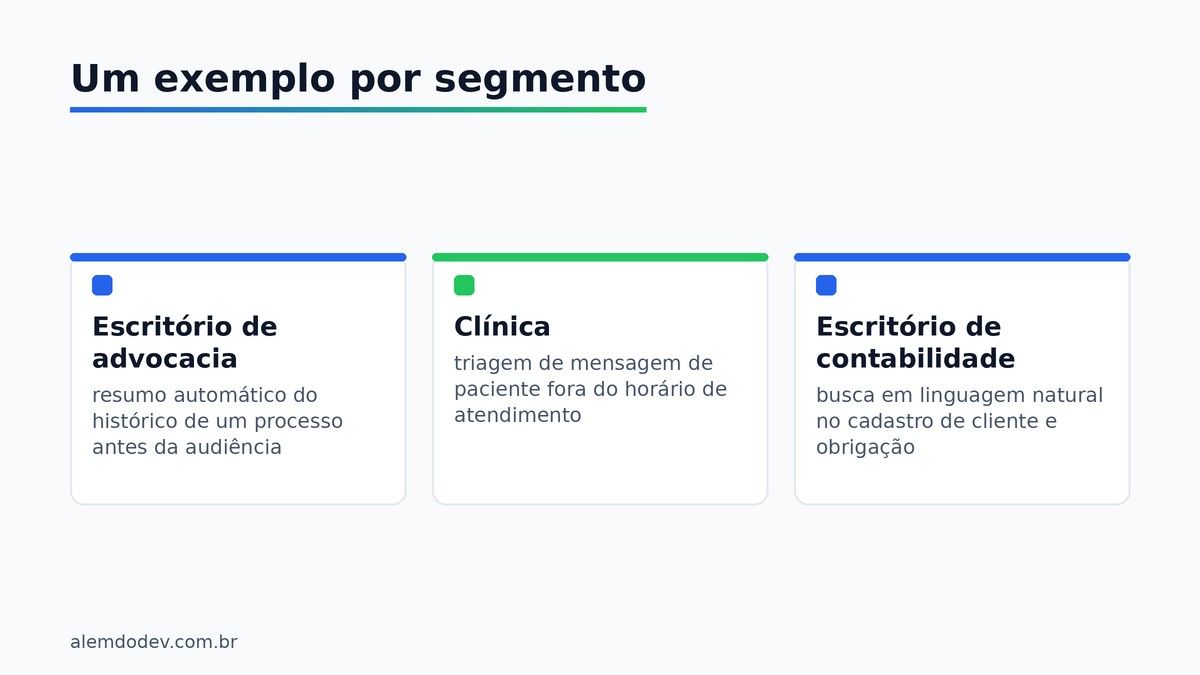
O ganho muda de cara conforme o segmento — a mesma queda de preço não abre a mesma porta para todo mundo. Um escritório de advocacia sente falta de resumo de processo; uma clínica sente falta de triagem de mensagem fora do horário; um escritório de contabilidade sente falta de busca rápida num cadastro que já tem anos de histórico acumulado.
O que ainda não vale a pena, mesmo mais barato
Nem toda ideia de IA vira aditivo só porque o token caiu de preço. Funcionalidade que decide algo sensível sozinha — aprovar crédito, definir preço, encerrar atendimento — continua exigindo revisão humana no meio do caminho, e isso não é custo de token: é desenho de processo, que preço de API nenhum resolve.
O mesmo vale para IA que tenta substituir um processo que ainda não existe de forma clara. Se hoje ninguém no time sabe descrever em três frases como a triagem de mensagem deveria funcionar, automatizar essa confusão com IA mais barata só faz o erro acontecer mais rápido.
Nos dois casos, o defeito não está no preço do token — está em pedir para a IA decidir algo que o próprio negócio ainda não decidiu por escrito. Isso continua exigindo o mesmo trabalho de sempre: levantar a regra, testar com caso real, revisar antes de confiar.
O próximo passo
Se uma das funcionalidades acima já soa familiar — porque você já sentiu falta dela, não porque acabou de ler sobre ela agora —, o próximo passo é simples: um diagnóstico sem custo, para levantar o que o sistema atual já faz e onde adicionar IA ao sistema entra sem virar mais uma coisa que ninguém revisa.